---
tags: [算法分析与设计]
abstract: RAM 模型、代价统计、渐进记号与排序分析
finished: false
上一篇: [[计算机系/算法分析与设计/02 伪代码与算法表达|上一篇]]
下一篇: [[计算机系/算法分析与设计/04 递归与分治算法|下一篇]]
返回目录: [[计算机系/算法分析与设计/算法分析|算法分析与设计学习指南]]
前置知识: [[计算机系/算法分析与设计/02 伪代码与算法表达|前置知识]]
---
# 运行时间与渐进分析
## 描述运行时间
l 算法,算法复杂度的基本概念;
l 时间复杂度的估算方法;
l 算法分析的数学基础,函数的渐近的界,递推方程求解方法。
l 算法复杂性:时间复杂性、空间复杂性、最优算法
l 算法复杂性分析:最坏情况和平均情况分析、如何估算运行时间
一般来说,算法所需时间是与输入规模同步增长的,因而一个程序的运行时间是其输入的函数。
输入规模:最自然的度量标准是输入中的元素个数
算法的运行时间
1、 独立于具体机器的“步骤”概念
2、 假定每次执行第i行所花的时间都是常量 $c_i$
我们首先给出过程 INSERTION-SORT 中,每条语句的执行时间和执行次数。对 $j=2, 3, \cdots, n$ ,其中 n=A.length,假设 $t_j$ 表示对那个值 j第 5 行执行 **while** 循环测试的次数。当一个 **for** 或 **while** 循环按通常的方式(即由于循环头中的测试)退出时,执行测试的次数比执行循环体的次数多 1。我们假定注释是不可执行的语句,所以它们不需要时间。
![[01 算法入门与正确性证明#^INSERTION]]
| line | cost | times |
| ------------------------------------------------ | ---- | -------------------------- |
| for j<-2 to length[A] | c1 | n |
| do key <-A[j] | c2 | n-1 |
| Insert A[j] into the sorted sequence A[1...j-1]. | 0 | n-1 |
| i<-j-1 | c4 | n-1 |
| while i>0 and A[i] >key | c5 | $\sum_{j=2}^{n} t_{j}$ |
| do A[i+1] <-A[i] | c6 | $\sum_{j=2}^{n} (t_{j}-1)$ |
| i<-i-1 | c7 | $\sum_{j=2}^{n} (t_{j}-1)$ |
| A[i+1]<-key | c8 | n-1 |
该算法的运行时间是执行每条语句的运行时间之和。需要执行 c_i 步且执行 n 次的一条语句将贡献 c_i n 给总运行时间。为计算在具有 n 个值的输入上 INSERTION-SORT 的运行时间 T\[n],我们将代价与次数列对应元素之积求和,得:
$$
T(n) = c_1 n + c_2(n-1) + c_4(n-1) + c_5 \sum_{j=2}^{n} t_j + c_6 \sum_{j=2}^{n} (t_j - 1) + c_7 \sum_{j=2}^{n} (t_j - 1) + c_8(n-1)
$$
该算法的运行时间依赖于输入规模以及具体输入。例如,在 INSERTION-SORT 中,若输入数组已排好序,则出现最佳情况。这时,对每个 $j=2,3,\cdots,n$,我们发现在第 5 行,当 $i$ 取其初值 $j-1$ 时,有 $A[i]\leqslant key$。从而对 $j=2,3,\cdots,n$,有 $t_j=1$,该最佳情况的运行时间为:
$$
\begin{aligned}
T(n) &= c_1 n + c_2(n-1) + c_4(n-1) + c_5(n-1) + c_8(n-1) \\
&= (c_1 + c_2 + c_4 + c_5 + c_8)n - (c_2 + c_4 + c_5 + c_8)
\end{aligned}
$$
我们可以把该运行时间表示为 $an+b$,其中常量 $a$ 和 $b$ 依赖于语句代价 $c_i$。因此,它是 $n$ 的线性函数。
若输入数组已反向排序,即按递减序排好序,则导致最坏情况。我们必须将每个元素 $A[j]$ 与整个已排序子数组 $A[1..j-1]$ 中的每个元素进行比较,所以对 $j=2,3,\cdots,n$,有 $t_j=j$。注意到
$$
\sum_{j=2}^{n} j = \frac{n(n+1)}{2} - 1
$$
和
$$
\sum_{j=2}^{n} (j-1) = \frac{n(n-1)}{2}
$$
我们发现在最坏情况下,INSERTION-SORT 的运行时间为
$$
\begin{aligned}
T(n) &= c_1 n + c_2(n-1) + c_4(n-1) + c_5\left(\frac{n(n+1)}{2} - 1\right) \\
&\quad + c_6\left(\frac{n(n-1)}{2}\right) + c_7\left(\frac{n(n-1)}{2}\right) + c_8(n-1) \\
&= \left(\frac{c_5}{2} + \frac{c_6}{2} + \frac{c_7}{2}\right)n^2 + \left(c_1 + c_2 + c_4 + \frac{c_5}{2} - \frac{c_6}{2} - \frac{c_7}{2} + c_8\right)n \\
&\quad - (c_2 + c_4 + c_5 + c_8)
\end{aligned}
$$
我们可以把该最坏情况运行时间表示为 $an^2+bn+c$,其中常量 $a$、$b$ 和 $c$ 又依赖于语句代价 $c_i$。因此,它是 $n$ 的二次函数。
评价一个算法可以从不同方面来考虑,如正确性,简单性、时间复杂性、空间复杂性
还可以提出求解某问题的最优算法
时间复杂性归结为某些基本操作的次数问题,基本操作的次数与问题的规模有关。我们一般考虑对基本操作的次数影响最大的量。
简单说:**用 cost × times 的表格,是“精确计算”;而用 $O(1)$ 和 $O(n^2)$ 的说法,是“渐近概括”。** 两者最终指向的结论是一致的,但表达的详细程度不一样。
表格方式(精确计算)
| 行 | 代码 | cost | times |
| ---- | ---------------------------- | ---- | ---------------------- |
| 5 | `while i > 0 and A[i] > key` | $c_5$ | $\sum_{j=2}^{n} t_j$ |
| 6 | `A[i+1] = A[i]` | $c_6$ | $\sum_{j=2}^{n}(t_j-1)$ |
| 7 | `i = i - 1` | $c_7$ | $\sum_{j=2}^{n}(t_j-1)$ |
| 8 | `A[i+1] = key` | $c_8$ | $n-1$ |
这里的 $c_5,c_6,c_7,c_8$ **就是**“内层循环每次执行所花的时间”,只不过我们把它用一个具体符号表示出来了。
- $c_5$:执行一次 `while` 条件判断花的时间。
- $c_6$:执行一次 `A[i+1] = A[i]` 花的时间。
- $c_7$:执行一次 `i = i - 1` 花的时间。
- $c_8$:执行一次 `A[i+1] = key` 花的时间。
**这些 $c_i$ 就是 $O(1)$。**
渐近方式(概括)
当我们说:
> “内层循环每次迭代的代价是 $O(1)$”
其实就是在说:
> “上面表格里的 $c_5,c_6,c_7,c_8$ 都是常量,不随 $n$ 变化。”
当我们说:
> “内层循环总次数是 $O(n^2)$”
其实就是在说:
> “上面表格里那些 $\sum_{j=2}^{n} t_j$ 和 $\sum_{j=2}^{n}(t_j-1)$,加起来是 $O(n^2)$。”
两者的对应关系
|表格里的量|渐近记号里的说法|
|---|---|
|$c_5,c_6,c_7,c_8$|每次语句执行的代价为常数 $O(1)$|
|$\sum_{j=2}^{n}t_j$|循环测试的总次数,最坏情况下为 $O(n^2)$|
|$c_5\sum t_j+c_6\sum(t_j-1)+\cdots$|内层循环的总时间,最坏情况下为 $O(n^2)$|
所以:**表格把单次代价和执行次数分开写;渐近分析则把它们合并成总时间的增长阶。**
先分清两个概念
|概念|含义|例子|
|---|---|---|
|**单次代价(cost)**|执行**一次**循环体所需的时间|$O(1)$|
|**总次数(times)**|整个算法中循环体的执行次数|$O(n^2)$|
|**总时间**|单次代价 × 总次数|$O(1)\times O(n^2)=O(n^2)$|
所以:
- “内层循环每次迭代的代价是 $O(1)$” → 说的是**单次代价**
- “内层循环执行次数是 $O(n^2)$” → 说的是**总次数**
- 两者相乘,才是整个内层循环的总时间 $O(n^2)$。
为什么“总次数”是 $O(n^2)$?
虽然每次代价是常数,但**执行的次数**和 n 有关。
最坏情况下(数组降序):
- 当 $j=2$,内层循环执行 1 次
- 当 $j=3$,内层循环执行 2 次
- 当 $j=4$,内层循环执行 3 次
- ……
- 当 当 $j=n$,内层循环执行 n−1 n−1 次
总次数:
$$
1+2+3+\cdots+(n-1)=\frac{n(n-1)}{2}=O(n^2)
$$
区别在哪里?
| 对比项 | 表格方式 | 渐近方式 |
| ---------- | -------------------------------- | ------------------------------- |
| **精确度** | 精确到每个常数 $c_i$ | 只保留增长量级 |
| **信息量** | 多(能看出每行贡献多少) | 少(只告诉你是 $O(n^2)$) |
| **用途** | 推导总时间 $T(n)$ 的精确表达式 | 比较算法效率、忽略硬件差异 |
| **结论** | 最终可以化简成 $an^2+bn+c$ | 直接写 $O(n^2)$ 或 $\Theta(n^2)$ |
$i=0$。所以内层循环的执行次数大约是 $1+2+3+\cdots+n$,也就是 $O(n^2)$。所以为什么内层循环以 $O(1)$(常量)为界?
这个问题问到了关键点,也是很多人看《算法导论》时最容易混淆的地方:
**“内层循环的执行次数是 $O(n^2)$,但为什么说内层循环每次迭代的代价是 $O(1)$?”**
答案很简单:**这是两个完全不同的东西。**
- 一个是说 **“次数”**(times)
- 一个是说 **“每次花的代价”**(cost)
我们把这两者分开看,你就彻底明白了。
------
先分清两个概念
| 概念 | 含义 | 例子 |
| -------------------- | -------------------------------- | ------------------------------------ |
| **单次代价(cost)** | 执行**一次**循环体,花多少时间 | $O(1)$ |
| **总次数(times)** | 整个算法里,循环体一共执行多少次 | $O(n^2)$ |
| **总时间** | 单次代价 × 总次数 | $O(1)\times O(n^2)=O(n^2)$ |
所以:
- “内层循环每次迭代的代价是 $O(1)$” → 说的是**单次代价**
- “内层循环执行次数是 $O(n^2)$” → 说的是**总次数**
- 两者相乘,才是整个内层循环的总时间 $O(n^2)$
------
为什么“单次代价”是 $O(1)$?
内层循环的循环体是:
```text
while i > 0 and A[i] > key
A[i+1] = A[i]
i = i - 1
```
**每执行一次循环体,具体做了哪些事?**
1. 比较 `i > 0`(一次比较)
2. 比较 `A[i] > key`(一次比较)
3. 赋值 `A[i+1] = A[i]`(一次数组访问 + 一次赋值)
4. 自减 `i = i - 1`(一次减法 + 一次赋值)
这些操作,**每一步都是基本操作**,不管 $n$ 多大,执行一次就是执行一次。
所以:
单次代价
$$
c_5+c_6+c_7=O(1)
$$
这里的 $c_5,c_6,c_7$ 是常数,与 $n$ 无关。
------
为什么“总次数”是 $O(n^2)$?
虽然每次代价是常数,但**执行的次数**和 $n$ 有关。
最坏情况下(数组降序):
- 当 $j=2$,内层循环执行 $1$ 次
- 当 $j=3$,内层循环执行 $2$ 次
- 当 $j=4$,内层循环执行 $3$ 次
- ……
- 当 $j=n$,内层循环执行 $n-1$ 次
总次数:
$$
1+2+3+\cdots+(n-1)=\frac{n(n-1)}{2}=O(n^2)
$$
------
为什么总时间是 $O(n^2)$?
总时间 = 单次代价 × 总次数
$$
O(1)\times O(n^2)=O(n^2)
$$
这就是为什么内层循环的整体时间复杂度是 $O(n^2)$,但**单次迭代**的代价是 $O(1)$。
------
------
回到图片原话
图片里说:
> “内层循环每次迭代的代价以 $O(1)$(常量)为上界,下标 $i$ 和 $j$ 均最多为 $n$,对于 $n^2$ 个 $i$ 和 $j$ 值对的每一对,内循环最多执行一次。”
1. **每次循环体执行**:花的时间是固定的 $O(1)$。
2. **有多少种 $i,j$ 组合**:最多 $n^2$ 种。
3. **每种组合最多执行一次**:所以总次数最多 $n^2$。
4. **总时间**:$O(1)\times n^2=O(n^2)$。
总结一句话
- **单次代价 $O(1)$**:因为一次循环只做几个基本操作,与 $n$ 无关。
- **总次数 $O(n^2)$**:因为内外层循环组合起来最多执行 $n^2$ 次。
- **总时间 $O(n^2)$**:两者相乘。
算法效率
求解同一个问题,不同的算法效率或复杂性不同
渐进复杂性
$$
\underset{n\rightarrow \infty}{\lim}\frac{T\left( n \right) -T^*\left( n \right)}{T\left( n \right)}=0
$$
设算法的运行时间为T(n),如果存在T*(n)
T*(n)称为算法的渐进性态或渐进时间复杂性
$$T^*\left( n \right) =7n^3
\\
\underset{n\rightarrow \infty}{\lim}\frac{T\left( n \right) -T^*\left( n \right)}{T\left( n \right)}=\underset{n\rightarrow \infty}{\lim}\frac{6n^2+5n+4}{7n^3+6n^2+5n+4}=0
\\
\text{当}n\rightarrow \infty ,T^*\left( n \right) =7n^3=n^3$$
N为算法中的问题规模,通常用大O/Ω/Θ等三种渐进符号表示算法执行时间和n之间的一种增长关系
算法:分析问题规模n,找出基本语句,求出其运行次数f(n).用O、Ω、Θ来表示其阶
渐近记号研究的对象是什么?
**渐近记号本质上研究的是“函数”,而不是直接的“算法”。**
- 算法本身是一堆代码。
- 算法的“运行时间”是一个关于输入规模 \(n\) 的函数(比如 \(T(n)\))。
- 我们写$\Theta(n^2)$,实际上是在描述 \(T(n)\) 这个函数的增长趋势。
我们到底在刻画哪种情况的运行时间?
作者特别强调:**必须明确你分析的是哪种运行时间。**
- 有时我们分析**最坏情况**(比如插入排序的最坏情况是 \(\Theta(n^2)\))。
- 但更多时候,我们想要一个**综合性的描述**,能够覆盖所有输入,而不是只看最坏情况。
- 对于归并排序,无论输入什么样,它的运行时间都是 \(\Theta(n \log n)\),这个记号就概括了它所有输入下的表现。
总结成一句话
> **“渐近记号”是为了扔掉繁琐且受硬件影响的精确常数,只保留输入规模 \(n\) 变大时起决定性作用的“增长量级”,从而让我们能在一个更高、更通用的维度上,去比较不同算法的优劣。**
#### 渐进记号
- 虽然有时候能够精确确定一个算法的运行时间,但通常没有必要去算出额外的精确度。
- 输入规模足够大时,常系数和低阶项对运行时间影响不大。
- 渐近分析更有意义(对不是很小的输入规模而言,从渐进意义上说更有效的算法就是最佳的选择)
紧确XX
##### 渐进(紧)确界
$$\Theta \left( g\left( n \right) \right) =\left\{ f\left( n \right) ,\exists c1,c2,n0,\forall n\ge n0,0\le c1g\left( n \right) \le f\left( n \right) \le c2g\left( n \right) \right\} $$
在集合的记号中,冒号指“使得”
也可以表示成
$$f\left( n \right) \in \Theta \left( g\left( n \right) \right) $$
$$f\left( n \right) =\varTheta \left( g\left( n \right) \right) $$

一个渐进正函数中低阶项在决定渐进确界时可以被忽略
高阶项的系数也可以忽略
##### 渐进上界
$$O\left( g\left( n \right) \right) =\left\{ f\left( n \right) :\exists c,n0,\forall n\ge n0,0\le f\left( n \right) \le cg\left( n \right) \right\} $$
$$\Theta \left( g\left( n \right) \right) \subseteq O\left( g\left( n \right) \right) $$
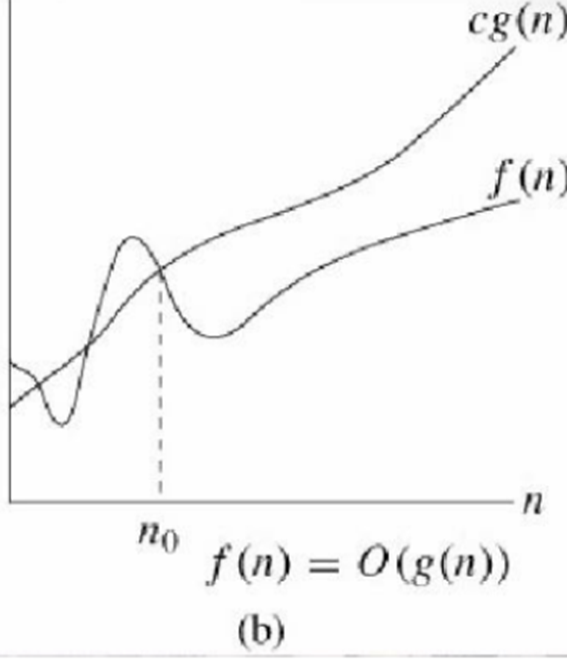 用O表示$T(n)=7n^3+6n^2+5n+4$的阶
1. 带入定义:$7n^3+6n^2+5n+4\leq{cf(n)}$
2. 如何取出c和n0?
3. 升阶:$7n^3+6n^2+5n+4\leq7n^3+6n^3+5n^3+4n^3=22n^3$
4. 存在c=22,n0=1,使得$n\geq{n0}$,令$f(n)=n^3$,$T(n)\leq{cf(n)=22n^3}$,即$T(n)=O(f(n))=O(n^3)$
直接升到最高次项
##### 渐进下界
$$\Omega \left( g\left( n \right) \right) =\left\{ f\left( n \right) :\exists c,n0,\forall n\ge n0,0\le cg\left( n \right) \le f\left( n \right) \right\} $$
$$\Theta \left( g\left( n \right) \right) \subseteq \Omega \left( g\left( n \right) \right) $$
删阶
用Ω表示$T(n)=7n^3+6n^2+5n+4$的阶
1. 带入定义:$7n^3+6n^2+5n+4\geq{cf(n)}$
2. 如何取出c和n0?
3. 升阶:$7n^3+6n^2+5n+4\geq7n^3$
4. 存在c=7,n0=1,使得$n\geq{n0}$,令$f(n)=n^3$,$T(n)\geq{cf(n)=7n^3}$,即$T(n)=Ω(f(n))=Ω(n^3)$
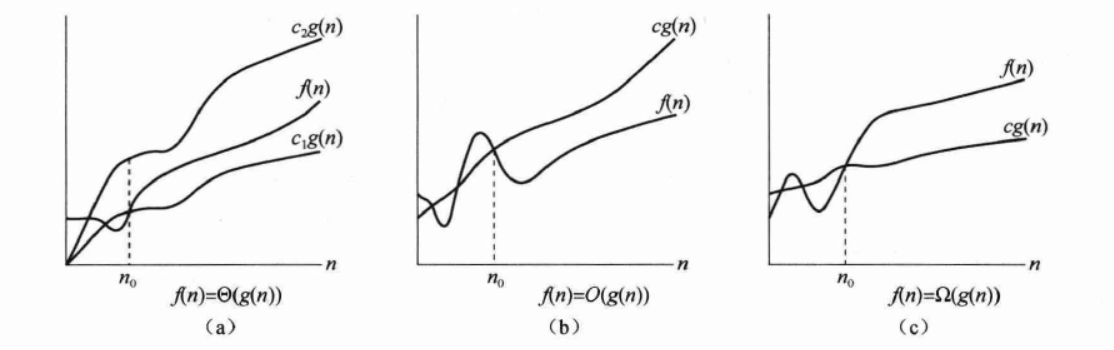
上界的阶越小,下界的阶越高,结果就越有价值
定理:$对于任意两个函数f(n)和g(n),f(n)=\Theta(g(n))当且仅当f(n)=\Omega (g(n))和f(n)=O(g(n))$
o 记号
由 $O$ 记号提供的渐近上界可能是也可能不是渐近紧确的。界 $2n^2 = O(n^2)$ 是渐近紧确的,但是界 $2n = O(n^2)$ 却不是。我们使用 $o$ 记号来表示一个非渐近紧确的上界。形式化地定义 $o(g(n))$(读作“小 $og(n)$”)为以下集合:
$$o(g(n)) = \{f(n) : \text{对任意正常量 } c > 0, \text{存在常量 } n_0 > 0, \text{使得对所有 } n \geq n_0, \text{有 } 0 \leq f(n) < cg(n)\}$$
例如,$2n = o(n^2)$,但是 $2n^2 \ne o(n^2)$。
$O$ 记号与 $o$ 记号的定义类似。主要的区别是在 $f(n) = O(g(n))$ 中,界 $0 \leq f(n) \leq cg(n)$ 对某个常量 $c > 0$ 成立,但在 $f(n) = o(g(n))$ 中,界 $0 \leq f(n) < cg(n)$ 对所有常量 $c > 0$ 成立。直观上,在 $o$ 记号中,当 $n$ 趋于无穷时,函数 $f(n)$ 相对于 $g(n)$ 来说变得微不足道了,即
$$
\lim_{n \to \infty} \frac{f(n)}{g(n)} = 0 \tag{3.1}$$
有些学者使用这个极限作为 $o$ 记号的定义;本书中的定义还限定匿名函数是渐近非负的。
$\omega$ 记号
$\omega$ 记号与 $\Omega$ 记号的关系类似于 $o$ 记号与 $O$ 记号的关系。我们使用 $\omega$ 记号来表示一个非渐近紧确的下界。定义它的一种方式是:
$$f(n) \in \omega(g(n)) \text{ 当且仅当 } g(n) \in o(f(n))$$
然而,我们形式化地定义 $\omega(g(n))$(读作“小 $\omega g(n)$”)为以下集合:
$$
\omega(g(n)) = \{f(n) : \text{对任意正常量 } c > 0, \text{存在常量 } n_0 > 0, \text{使得对所有 } n \geq n_0, \text{有 } 0 \leq cg(n) < f(n)\}$$
例如,$n^2/2 = \omega(n)$,但是 $n^2/2 \ne \omega(n^2)$。关系 $f(n) = \omega(g(n))$ 蕴涵着
$$\lim_{n \to \infty} \frac{f(n)}{g(n)} = \infty$$
也就是说,如果这个极限存在,那么当 $n$ 趋于无穷时,$f(n)$ 相对于 $g(n)$ 来说变得任意大了。
函数间关系
- f(n)和g(n)都是渐近正值函数
- 传递性:
$$
f(n)=\Theta(g(n))和g(n)=\Theta(h(n))蕴含f(n)=\Theta(h(n))\\
f(n)=O(g(n))和g(n)=O(h(n))蕴含f(n)=O(h(n)) \\
f(n)=\Omega(g(n)) 和g(n)=\Omega(h(n))蕴含f(n)=\Omega(h(n))
$$
渐近记号$\ O \Omega \Theta$ 规律:若T(n)是一个一元多项式,最高项次数是$n^m,T(n)=O(n^m)=\Omega(n^m)=\Theta(n^m)$
时间复杂度排行$O(1)b
对于函数,三分性不成立,对于两个函数f(n)和g(n),可能$f(n)=O(g(n))和f(n)=\Omega(g(n))$都不成立
$$n和 n^{1+\sin n}$$无法利用渐近符号来比较
三个记号的定义
| 记号 | 含义 | 直观理解 |
| -------------- | ----- | ----------------------- |
| $O(f(n))$ | 渐进上界 | 运行时间**不会超过** $f(n)$ 的量级 |
| $\Omega(f(n))$ | 渐进下界 | 运行时间**不会低于** $f(n)$ 的量级 |
| $\Theta(f(n))$ | 渐进紧确界 | 运行时间**恰好**在 $f(n)$ 的量级 |
应用到插入排序
| 说法 | 严谨吗? | 实际含义 |
| ------------------------------------- | -------- | ------------------------------------------------ |
| 插入排序运行时间是 $O(n^2)$ | 不严谨 | 存在 $O(n^2)$ 的函数,是所有输入运行时间的上界 |
| 插入排序最坏情况运行时间是 $O(n^2)$ | 严谨 | 最坏情况不超过 $n^2$ |
| 插入排序运行时间是 $\Omega(n)$ | 不严谨 | 存在 $\Omega(n)$ 的函数,是所有输入运行时间的下界 |
| 插入排序最好情况运行时间是 $\Omega(n)$ | 严谨 | 最好情况不低于 $n$ |
| 插入排序运行时间是 $\Theta(n^2)$ | **错** | 最好情况是 $\Theta(n)$,不是 $\Theta(n^2)$ |
| 插入排序最坏情况运行时间是 $\Theta(n^2)$ | 严谨 | 最坏情况恰好是 $n^2$ 量级 |
一句话总结三者
| 记号 | 对应插入排序的哪种情况 |
| ---------- | ------------- |
| $O(n^2)$ | 最坏情况的上界 |
| $\Omega(n)$ | 最好情况的下界 |
| $\Theta(n^2)$ | 仅当说“最坏情况”时才成立 |
第二层:那“运行时间为 $O(n^2)$”到底在说什么?
虽然表述不严谨,但大家都懂它的意思。作者把这个隐含的意思明确写出来了:
> **存在一个 $O(n^2)$ 的函数 $f(n)$,使得对 nn 的任意值,不管选择什么特定的规模为 nn 的输入,其运行时间的上界都是 $f(n)$。**
翻译成大白话:
- 虽然不同输入下运行时间不同,但**总有一个上限**。
- 这个上限不会超过 $n^2$ 量级的某个函数。
- 换句话说,**无论你怎么刁难这个算法,它都不会比 $f(n)$ 更慢。**
这为什么就等于“最坏情况运行时间为 $O(n^2)$”?
因为 $f(n)$ 是**所有输入**的上界,那它自然也是**最坏情况**的上界。
- “所有输入的运行时间 $\le f(n)$”
- 等价于
- “最坏情况的运行时间 $\le f(n)$”
所以:
> “存在 $O(n^2)$ 的函数 $f(n)$ 是所有输入的上界”
> $\Longleftrightarrow$
> “最坏情况运行时间为 $O(n^2)$”
类似地:
> “插入排序的运行时间为 $O(n^2)$”
意思是:
> “不管输入是什么,插入排序的运行时间都不会超过某个 $n^2$ 量级的函数。”
这等价于:
> “插入排序的最坏情况运行时间为 $O(n^2)$。”
### 举例:直接用眼睛看插入排序
```text
for j = 2 to n // 外层 n 次
key = A[j]
i = j - 1
while i > 0 and ... // 内层最多 j 次
A[i+1] = A[i]
i = i - 1
```
- 外层:n次
- 内层:最多 n 次(因为 j最大是 n,i 从 j−1 递减到 0)
- 嵌套层数:2 层
所以整体最坏是 $O(n\times n)=O(n^2)$=O(n 2)。
### 举个例子
假设你算出来:
$$
T(n)=3n^2+5n+100
$$
化简过程:
1. 去掉常数系数:$n^2+n+1$
2. 只保留最高阶:$n^2$
3. 加上记号:$\Theta(n^2)$
## 四、一句话总结
**从表格到 $O$ 的判断逻辑是:**
1. 先数循环嵌套层数,直接猜出“最高阶项的形式”。
2. 再用公式化简规则,把低阶项和常数系数扔掉。
3. 最后套上 $O$ 或 $\Theta$。
掌握了这个,你就不需要每次都把 $T(n)$ 完整展开再算了,看到代码就能直接报出复杂度。
## 渐进记号的严格含义
> [!definition] 大 $O$、大 $\Omega$ 与 $\Theta$
> $f(n)=O(g(n))$ 表示存在常数 $c>0,n_0$,使 $0\le f(n)\le c g(n)$($n\ge n_0$);$f(n)=\Omega(g(n))$ 表示存在 $c>0,n_0$ 使 $f(n)\ge c g(n)$;若二者同时成立,则 $f(n)=\Theta(g(n))$。
> [!theorem] 多项式最高阶项决定渐近阶
> 若 $p(n)=a_kn^k+a_{k-1}n^{k-1}+\cdots+a_0$ 且 $a_k>0$,则 $p(n)=\Theta(n^k)$。
> ^thm-asymptotic-equivalence
> [!proof]- 证明
> 对 $n\ge1$,有 $p(n)\le (|a_k|+\cdots+|a_0|)n^k$,故为 $O(n^k)$。另一方面,低阶项与最高阶项之比趋于 $0$,存在 $n_0$ 使 $p(n)\ge (a_k/2)n^k$($n\ge n_0$),故为 $\Omega(n^k)$。
作为一个例子,考虑任意二次函数 $f(n)=an^2+bn+c$,其中 $a$、$b$ 和 $c$ 均为常量且 $a>0$。扔掉低阶项并忽略常量后得 $f(n)=\Theta(n^2)$。为了形式化地证明相同的结论,我们取常量 $c_1=a/4$, $c_{2}=7a/4$ 且 $n_0=2\bullet\max(|b|/a,\sqrt{|c|/a})$。可以证明对所有 $n\geqslant n_0$,有 $0\leqslant c_1n^2\leqslant an^2+bn+c\leqslant$ $c_2n^2$。一般来说,对任意多项式 $p(n)=\sum_i=0^da_in^i$ ,其中 $a_i$ 为常量且 $a_d>0$,我们有 $p(n)=\Theta(n^d)$
证明:$\frac 14$ 和 $\frac 74$ 并不是唯一答案,只是为了方便而选的常数。
关键是把低阶项 \(bn+c\) 控制在 \(an^2\) 的一部分以内。由 \(n\) 足够大,可以让
$$
|b|n\le \frac a 2 n^2,\qquad |c|\le \frac a 4 n^2.
$$
于是低阶项总量满足
$$
|b|n+|c|\le \frac{3 a}{4}n^2.
$$
因此:
$$
f(n)\ge an^2-\frac{3 a}{4}n^2=\frac a 4 n^2,
$$
$$
f(n)\le an^2+\frac{3 a}{4}n^2=\frac{7 a}{4}n^2.
$$
所以出现了 $\frac 14$ 和 $\frac 74$。
更一般地,只要取任意 $0<\varepsilon<1$,令 $n$ 足够大,使得
$$
|bn+c|\le \varepsilon an^2,
$$
就有
$$
(1-\varepsilon)an^2\le f(n)\le (1+\varepsilon)an^2.
$$
例如取 $\varepsilon=\frac 12$,就能得到
$$
\frac a 2 n^2\le f(n)\le \frac{3 a}{2}n^2.
$$
这同样可以证明 $f(n)=\Theta(n^2)$。因此,证明重点不是记住 $\frac 14,\frac 74$,而是找到两个固定正数,把低阶项相对于 $an^2$ 压住。